DOM? 그게 뭔데!
목차
돔? 고척에있는 거기?
 [ 고척 스카이돔 ]
우리는 "돔"이라고 하면 흔히 고척돔 같은 야구장을 떠올리지만, 프로그래밍에서 말하는 DOM은 전혀 다른 개념이다.
한번 추측을 해보자
" Model 이 들어가는거 보면 무언가의 구조일것 같고.. " " 앞에 Document 와 Object가 들어가는걸 보면 Document와 Object에 관한 구조인가? " 라는 생각을 한 당신. 정답이다.
DOM은 Document Object Model의 약자로, HTML이나 XML 문서를 프로그래밍 언어가 다룰 수 있도록 해주는 인터페이스다.
프로그래밍 인터페이스? 무언가 예상이 가는 이름 아닌가? 맞다, DOM은 프로그래밍 언어와 스크립트를 웹페이지(문서)에 연결해주는 역할을 한다! 이해가 잘 가지 않는다면 비유를 한번 해보겠다. 웹 개발을 할때 백엔드와 프론트엔드를 연동하기 위해서는 Application Programming Interface(API)가 필요하다. 문서를 프론트엔드 프로그래밍 언어를 백엔드라고 치환하면 DOM은 API와도 같은것이다.
물론 DOM이 Programming Interface만 되는것은 아니다. 우리가 자주쓰는 <Body> 태그 <p> 태그 등도 DOM의 Node로서 포함된다.
DOM은 태그등으로 Structured Representation(구조화된 표현)을 제공하며. 외부에서 DOM구조에 접근하여 문서를 변경하는것을 지원한다.
Document 는 알겠어. 그러면 Object는?
DOM은 nodes 와 object로 구성되어있다. "Object? 객체로 구성되어있다고?" 생각하는 그게 맞다.
DOM은 문서를 표현,저장,조작하는 방법을 제공하는 Webpage의 객체 지향 표현이다. 조금 더 정확하게는 HTML 문서 구조의 '계층'을 표현하는 객체이다.
DOM은 Node의 집합으로 이루어진 하나의 큰 Tree 이다. 그리고 그 Node 들은 **객체(Object)**로 구성이 되어있다
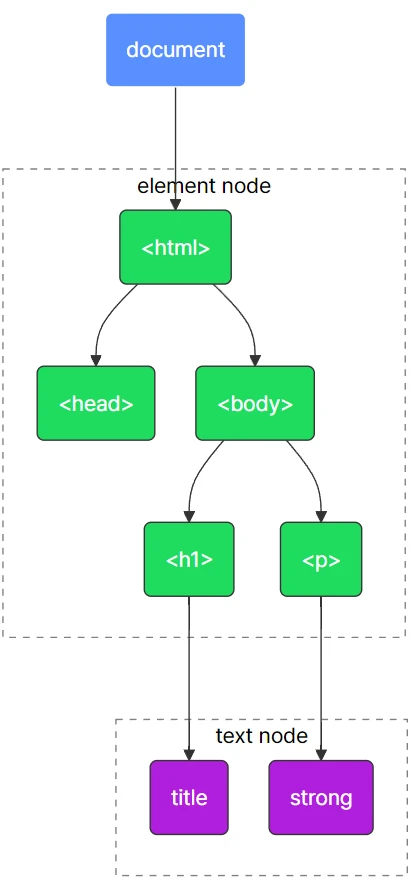 [ DOM 트리구조 예시 ]
트리를 한번 살펴보자. DOM 의 첫번째 단어 Document로 부터 branch들이 하위 node 로 뻗어나가는 형태이다.
Document Node를 해석할땐 Document 객체가. HTML 노드를 해석할땐 HTMLElement 객체가. textnode들을 해석할땐 Text 객체가 활용된다.
그럼 DOM은 어떤 Node를 포함하는데?
DOM이 Tree로 구성되어있고 Node 들을 포함한다면. DOM은 기본적으로 어떤 Node들을 요구할까? DOM은 기본적으로 아래와 같은 Node들로 구성된다.
- Document Node : 전체 HTML 문서의 Root Node
- Element Node : 실제로 작성된 HTML의 태그 요소들 (
<div>,<span>등) - Text Node : 태그 안에 들어간 렌더링 되어야 하는 텍스트값
- Attribute Node : id, class 등 태그에 부여된 속성값
- Comment Node :
<!-- -->로 구성된 주석
확인해 보면 실제 렌더링에 필요하지 않은 주석까지 모든 요소를 Node로 변경하여 DOM Tree를 구성한다. 사실상 HTML 다큐먼트를 하나의 Tree 로 재구성 한다고 볼 수 있다.
DOM이 한번 렌더링 되면 변경은 안되는거야?
앞에서 우리는 DOM은 HTML을 해석해서 Tree 구조로 변경한다했다. 그럼 Tree의 요소를 변경해서 동적으로 사용할 수는 없을까?
감사하게도 DOM은 Tree의 Node에 접근 할 수 있는 API를 제공한다.
API List

// 요소를 찾아주는 API
document.getElementById(id); // ID를 기준으로 요소를 반환한다.
document.getElementsByClassName(className); // ClassName을 기준으로 요소들을 반환한다.
document.getElementsByTagName(tagName); // TagName을 기준으로 요소들을 반환한다.
document.querySelector(selector); // selector Param을 기준으로 가장 첫번째 요소를 반환한다.
document.querySelectorAll(selector); // selector Param을 기준으로 모든 요소를 Node List로 반환한다.

// 요소의 내용을 변경하는 API
element.textContent; // 텍스트 변경
element.innerHTML; // HTML을 포함하여 변경
element.innerText; //렌더링 된 텍스트를 기준으로 변경

// 요소를 추가 / 삭제하는 API
document.createElement(tagName); //TagName에 해당하는 Node를 새로 생성.
element.appendChild(node); //마지막 ChildNode 로 DOM Tree에 편입.
element.prepend(node); // 첫번째 ChildNode 로 DOM Tree에 편입.
element.insertBefore(newNode, referenceNode); // 특정 위치에 Node를 삽입.
element.removeChild(node); // ChildNode를 삭제.
element.replaceChild(newNode, oldNode); //Node를 교체.

// 속성을 조작하는 API
element.getAttribute(name); // 속성 값을 반환
element.setAttribute(name, value); // 속성 값을 설정한다.
element.removeAttribute(name); // 속성을 삭제한다.
element.hasAttribute(name); // 속성의 존재 여부를 확인한다.

// 스타일을 조작하는 API
element.style.property = value; // 인라인 스타일 적용.
element.classList.add(name); // 클래스를 추가한다.
element.classList.toggle(name); // 토글
element.classList.contains(name); // 클래스 존재 여부 확인

// 이벤트를 조작하는 API
element.addEventListener(type, handler);
element.removeEventListener(type, handler);
DOM은 이러한 API들을 우리에게 제공하고. 우리는 이것을 Javascript에서 활용하여 DOM을 조작할 수 있다.
결국 Tree 구조면 DOM 도 순회를 하겠네?
DOM은 기본적으로 DOM Tree 를 순회하며 화면에 표시할 Rendering Tree를 생성한다. 이 부분에서 DOM의 약점이 한가지 들어난다.
" Tree가 깊어질수록 최적화가 급격하게 나빠지는 현상 "
DOM도 Tree 로 이루어져있기 때문에 어쩔수없이 구조가 깊어질수록 탐색에 시간이 더 걸리게 되며 최적화에서 손해를 볼 수 밖에 없다.
조금 더 구체적으로 들어가보자. DOM 의 모든 단일 노드는 오버헤드를 일으키게 된다. 이 말은 즉, 단일 노드의 갯수가 많아지고 HTML이 복잡해질수록 작업량이 급격하게 많아진다는 뜻이다. 이로 인하여 DOM Tree 가 거대해질수록 웹의 최적화는 급격하게 나빠질 수 밖에 없다.
오버헤드(Overhead) : 특정 작업을 완료하기 위하여 사용되는 추가적인 시간과 메모리
그러면 DOM은 불완전한 구조 아니야?
 복잡해질수록 성능이 급격하게 떨어진다는 부분은 DOM이 불완전한 구조가 아닌가 의심이 들게 할 수 있다.
하지만, 사실 DOM은 애초부터 불완전을 전제로 설계되었다.
HTML은 다른 언어들과 다르게 "완벽하게 닫힌 문법(Closed Bracket)"을 강제하지 않는다. 우리가 무언가 빠트려 불완전한 Document를 작성하더라도 DOM에서 보정을 해준다는 이야기다.
예를 들어보자.
우리가 <p>태그 안에 글을 작성하고 태그를 닫는것을 잊어버렸다 가정해보자.
이 Document를 실행하게 되면 브라우저는 사용자가 작성한 불완전한 HTML을 받아들이고 자동적으로 보정한 DOM을 생성한다
이런 작업이 있기에 우리가 작성한 HTML은 실제 DOM Tree와 완벽하게 일치하지 않을 수 있다. 이러한 상황에 대표적인 실제 예시가 있다. 우리가 HTML에 List를 작성한다면 아래와 같이 작성할 것이다.
<table id='table'>
<tr>
<td>
샘플 텍스트1
</td>
<td>
샘플 텍스트2
</td>
</tr>
</table>
분명 DOM 명세서에서는 테이블에 반드시 <tbody> 태그가 있어야 한다고 적혀있다. 하지만 우리는 일반적으로 <tbody>를 생략하고 작성합니다.
이때 브라우저는 불완전한 HTML에 tbody를 자동으로 생성하여 DOM Tree를 구성합니다.
즉, DOM은 완벽한 설계 산물이라기보다 불완전한 입력을 견디고, 현실 속 다양한 상황을 수용하기 위해 태어난 구조다. 이런 태생적 이유 때문에 DOM은 강력하면서도 동시에 여러 성능적/구조적 한계를 지니게 될 수밖에 없었습니다.
DOM 그 한계를 넘어서
앞서 이야기했듯 DOM은 트리 구조로 되어 있어, 노드 수가 많아질수록 탐색과 조작에 큰 비용이 든다. 한두 개의 요소를 바꾸는 것처럼 보이더라도, 브라우저는 내부적으로 트리 전체를 다시 계산해야 할 때가 많다. 이 때문에 대규모 웹 애플리케이션에서는 DOM 조작 자체가 성능 병목이 되곤 한다.
이 문제를 해결하기 위해 Virtual DOM과 Shadow DOM이 등장하였다.
Virtual DOM이란 실제 DOM을 다루지 않고, 메모리 상에 존재하는 가상의 DOM 트리를 먼저 수정한 후 최소한의 변경점만 실제 DOM에 적용하여 성능적 병목을 해결하고자 하는 개념이다.
React, Vue 등 현대에서 주로 쓰이는 Frontend 프레임워크 들에서 채용하고 있는 개념이다.
Shadow DOM이란 컴포넌트 단위로 독립적인 DOM 트리를 만들어 컴포넌트 단위로 관리할 수 있게 만든 개념이다.
Web Component에서 채용하고 있는 개념이다.
끝내며
DOM은 Frontend 개발자에게 필수적인 개념이다. 직접 DOM을 조작해야 하는 직군이며, 시간이 지날수록 웹은 아주 빠른속도로 변화하고있기 때문이다.
물론 DOM은 태생적으로 불완전성과 성능적 한계를 안고있다. 그러나, Virtual DOM, Shadow DOM 같은 이를 보완하고자 하는 개념들이 등장하며 바르게 보완되고있다.
아마 이 글을 읽는 개발자들 중 HTML+CSS+JS로 프론트 개발을 해본 적 없이 React, Vue 등의 Framework로 프론트 개발을 시작한 사람 또한 있을것이다.
DOM의 구조를 이해하고 머릿속에 그리면서 개발한다면, 한 단계 성장할 수 있는 계기가 될 것이라 생각한다.
참고 자료
모던 자바스크립트 튜토리얼 - DOM 트리 https://ko.javascript.info/dom-nodes MDN - DOM 소개 https://developer.mozilla.org/ko/docs/Web/API/Document_Object_Model/Introduction Toss Payments 개발자센터 - 문서 개체 모델(DOM) https://docs.tosspayments.com/resources/glossary/dom
읽어주셔서 감사합니다.